Autor
Inhaltsverzeichnis
- Site Reliability Engineer: Key Facts
- SRE, DevOps Engineer und Platform Engineer: die Abgrenzung
- Aufgaben eines Site Reliability Engineers
- Anforderungen an einen Site Reliability Engineer
- Gehalt: Was verdient ein Site Reliability Engineer?
- Wie wird man Site Reliability Engineer?
- Wie KI die Rolle des Site Reliability Engineers verändert
- Ihr Headhunter für Site Reliability Engineers
Das Wichtigste in Kürze
Ein Site Reliability Engineer (SRE) sorgt dafür, dass Software-Systeme und Cloud-Plattformen unter Last zuverlässig laufen. Anders als in der klassischen Administration endet seine Arbeit nicht mit dem Neustart eines Dienstes, denn nach einem Ausfall sucht er die Ursache und hält die Gegenmaßnahme anschließend in Code fest. Wie viel Ausfall zulässig ist, legen Service Level Objectives und ein Fehlerbudget fest, sodass sich die Arbeit an messbaren Zielen ausrichten lässt. Dieser Beitrag geht auf Aufgaben, Anforderungen und Gehalt ein.
Site Reliability Engineer: Key Facts
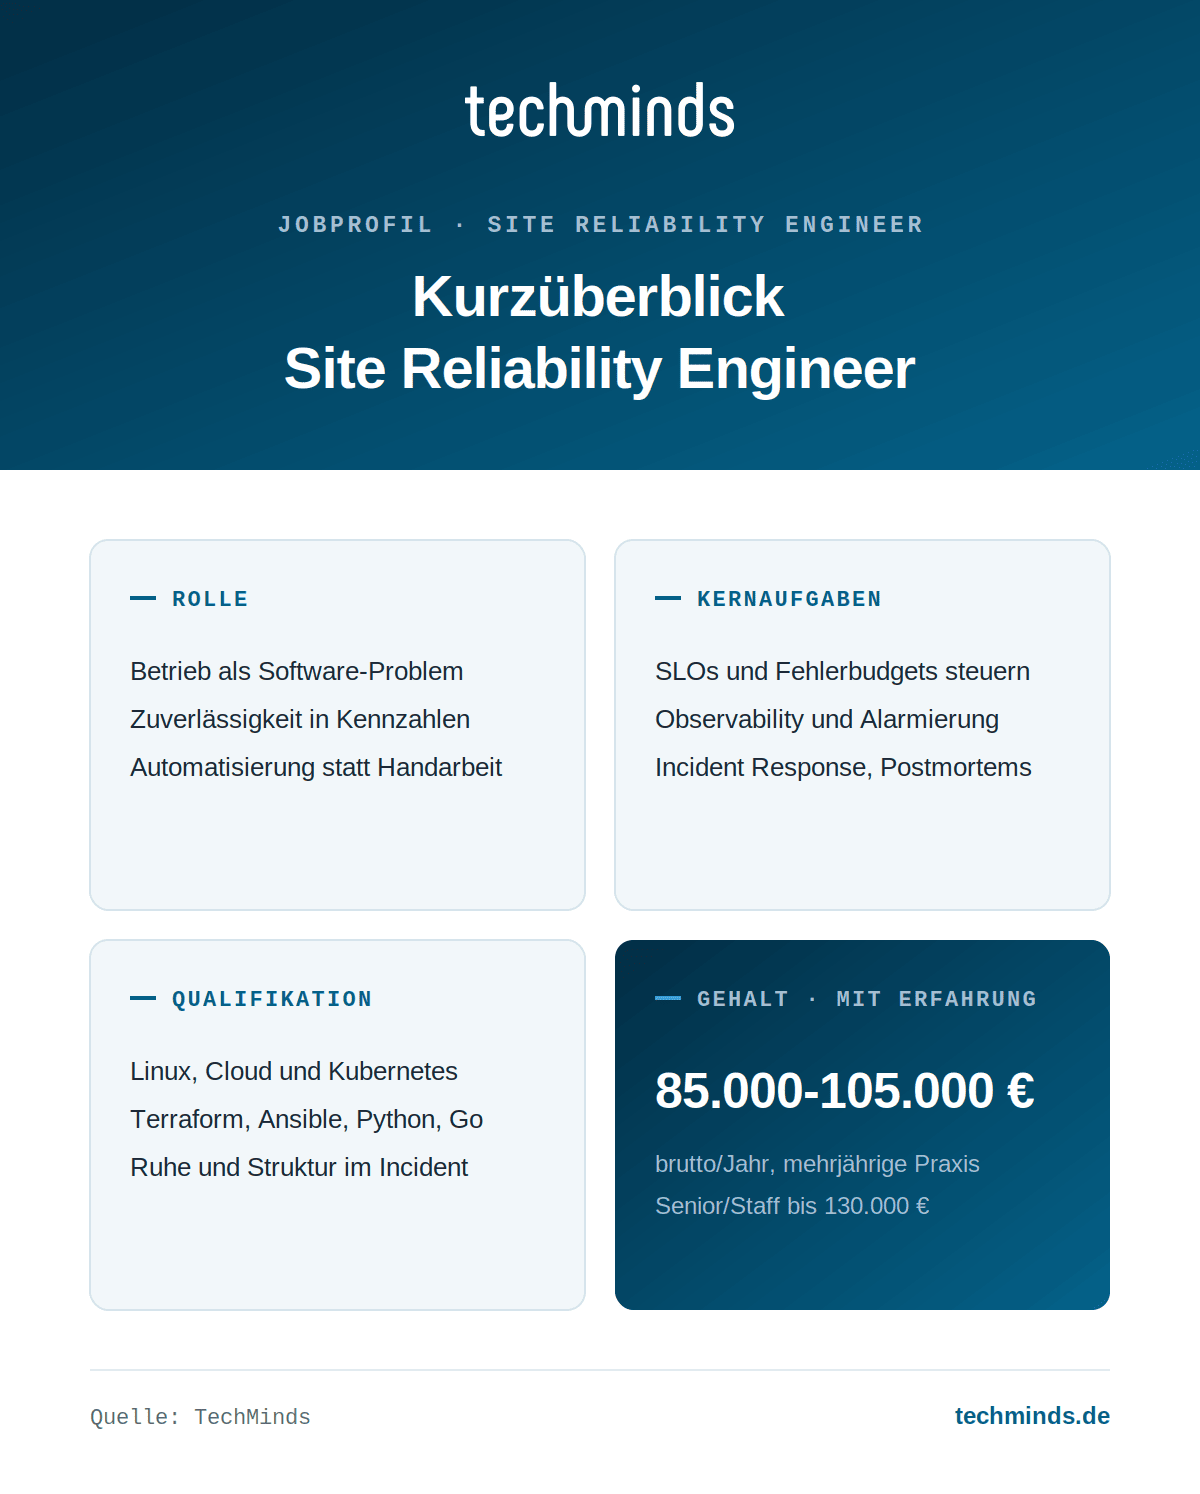
Was macht ein Site Reliability Engineer?
Am Anfang steht eine unbequeme Frage an das Produktteam: Wie viel Ausfall darf dieser Dienst im Monat haben? Aus der Antwort werden Service Level Objectives, und daran richtet sich der Rest aus. Die Überwachung baut er selbst auf. Infrastruktur beschreibt er als Code. Für kritische Systeme trägt er die Rufbereitschaft mit. Tritt eine Störung auf, koordiniert er die Incident Response. Danach folgt die Ursachenanalyse ohne Schuldzuweisung, mit dem Ziel, denselben Fehler nicht zweimal zu erleben. Hinzu kommt die Kapazitätsplanung. In vielen Häusern schaut die Geschäftsführung inzwischen genauso genau auf die Cloud-Rechnung wie auf die Verfügbarkeit.
Wie viel verdient ein Site Reliability Engineer?
Ein Site Reliability Engineer verdient in Deutschland i.d.R. zwischen 70.000 und 95.000 Euro brutto im Jahr. Berufseinsteiger mit Betriebs- oder Entwicklungserfahrung starten bei rund 60.000 Euro, mit mehrjähriger Praxis sind 85.000 bis 105.000 Euro üblich; Senior und Staff SREs in Konzernen, FinTechs und großen SaaS-Anbietern erreichen 110.000 bis 130.000 Euro.
Worin unterscheidet sich der Site Reliability Engineer vom DevOps Engineer?
DevOps beschreibt eine Arbeitsweise, in der Entwicklung und Betrieb zusammenrücken, und der DevOps Engineer baut dafür die Pipelines, das Tooling und die Infrastruktur. Im Site Reliability Engineering kommen messbare Ziele dazu. Ein SRE arbeitet mit Fehlerbudgets und Verfügbarkeitszielen und entscheidet anhand dieser Zahlen, ob ein neues Feature ausgeliefert wird oder die Stabilität Vorrang hat.
Welche Qualifikationen braucht ein Site Reliability Engineer?
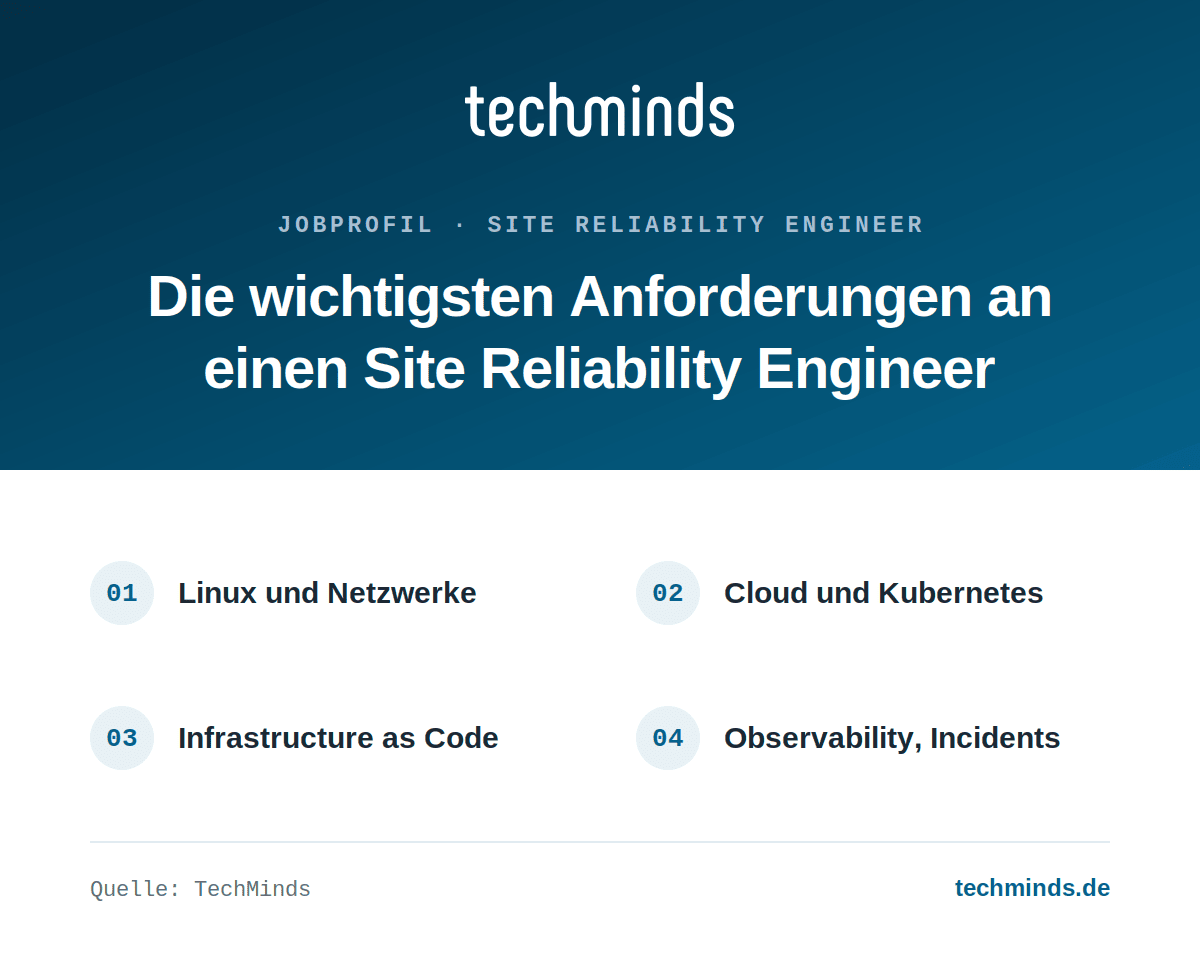
Vorausgesetzt wird ein sicherer Umgang mit Linux und mit einer der großen Cloud-Plattformen, also AWS, Azure oder Google Cloud. Kubernetes gehört inzwischen zum Standard. Infrastruktur wird als Code beschrieben, meist mit Terraform, und über Pipelines ausgerollt. Hinzu kommt eine Programmiersprache wie Python oder Go: Ein SRE automatisiert seine Arbeit, anstatt sie zu wiederholen.
SRE, DevOps Engineer und Platform Engineer: die Abgrenzung
Die drei Rollen überschneiden sich stark. In Stellenanzeigen werden sie ohnehin oft verwechselt. Der DevOps Engineer sorgt dafür, dass Code schnell und wiederholbar in die Produktion kommt. Sein Feld sind Build- und Auslieferungsprozesse. Der Platform Engineer baut die interne Entwicklerplattform. Über sie holen sich die Teams Infrastruktur und Deployments selbst, ohne bei jedem Schritt nachfragen zu müssen. Beim Site Reliability Engineer geht es um die Frage, ob das Ergebnis im Betrieb hält. Er verantwortet Verfügbarkeit und Latenz. Fällt etwas aus, ist er derjenige, der geweckt wird. Im Projektalltag arbeitet die Rolle eng mit Profilen wie Cloud Architect zusammen.
Ob die Rollen getrennt sind, hängt an der Größe. Große Plattformbetreiber leisten sich eigene SRE-Teams. Im Mittelstand macht ein kleines Team alles, was hier auf drei Rollen verteilt beschrieben ist. Nach oben führt der Weg über Senior und Staff SRE. Wer lieber führt als selbst baut, landet als Engineering Manager Reliability oder Head of Platform.
Aufgaben eines Site Reliability Engineers
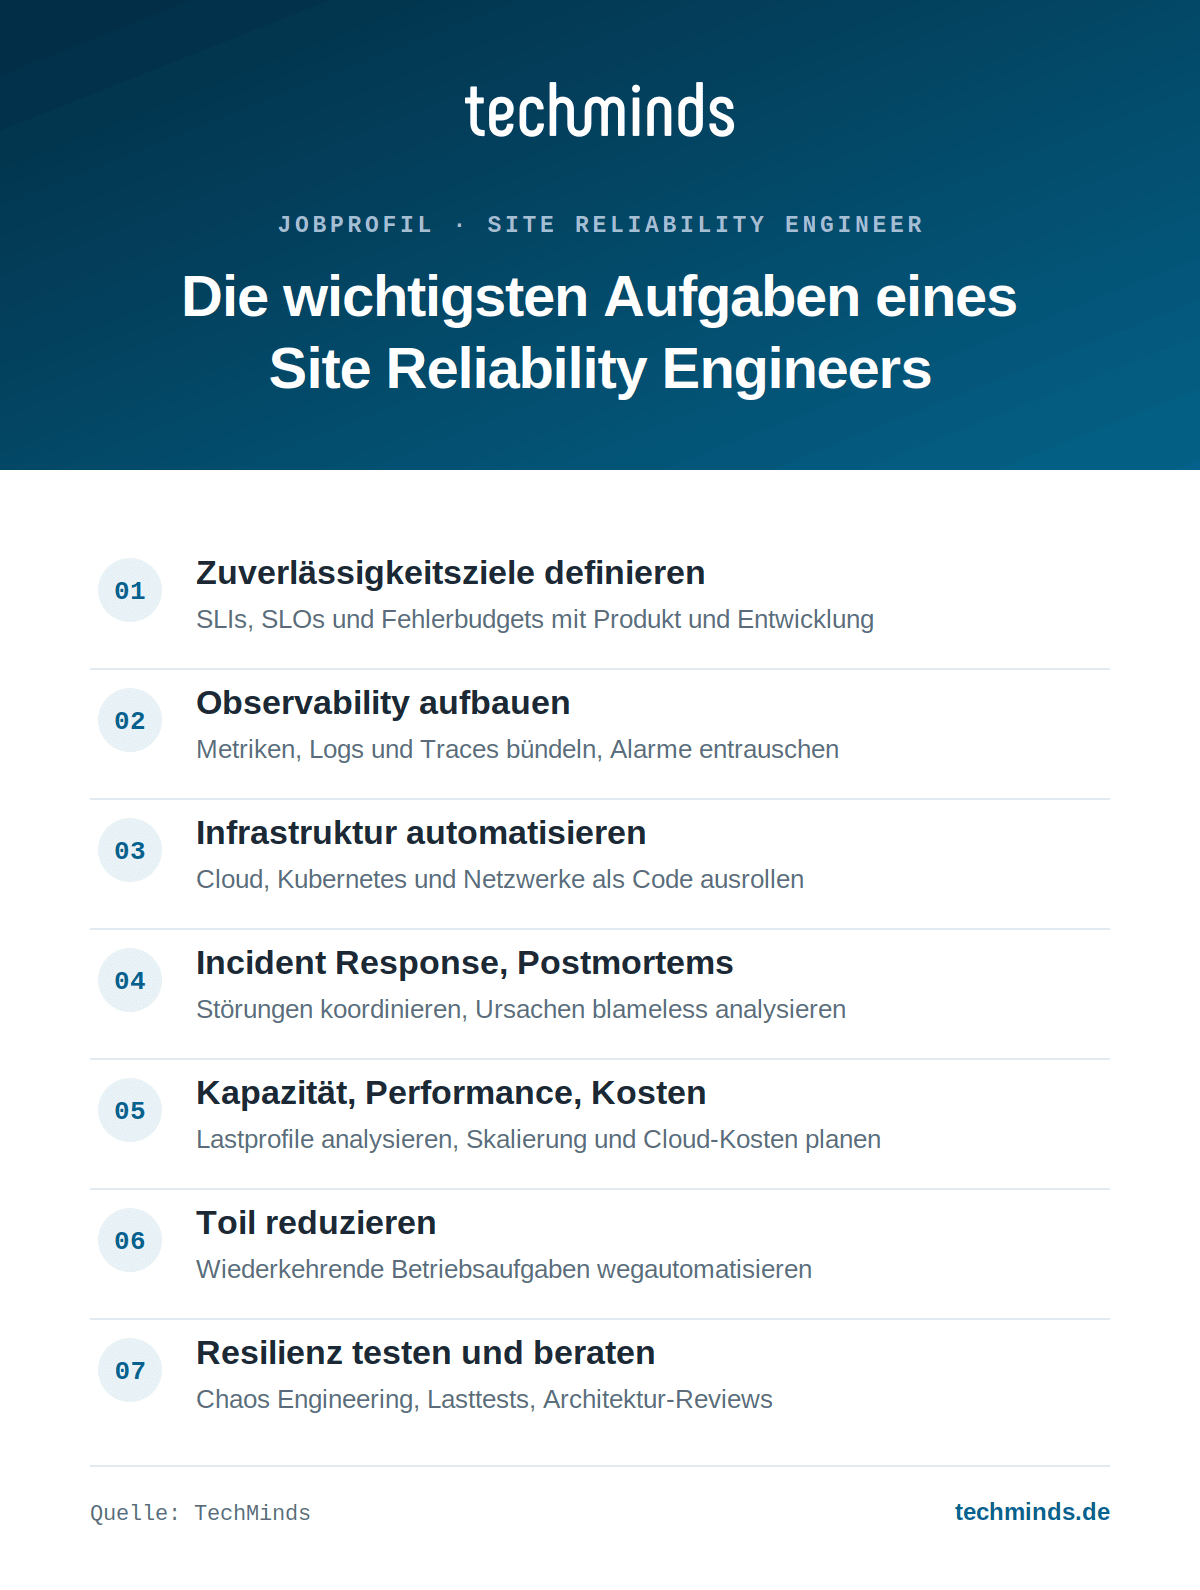
Das Aufgabenspektrum reicht von Architekturberatung bis Incident Response. Zum Kern gehören:
Anforderungen an einen Site Reliability Engineer
Gehalt: Was verdient ein Site Reliability Engineer?
SREs verdienen mehr als reine Administratoren. Der Aufschlag kommt daher, dass zwei Kompetenzen zusammenkommen, die selten in einer Person stecken. Wer aus der Administration kommt, startet meist bei 60.000 bis 70.000 Euro. Der Marktdurchschnitt liegt darüber, bei 70.000 bis 95.000 Euro.
Mit mehrjähriger Erfahrung im Betrieb kritischer Systeme sind 85.000 bis 105.000 Euro üblich, in München, Frankfurt und Hamburg tendenziell am oberen Rand. Auf Senior- und Staff-Ebene sind 110.000 bis 130.000 Euro drin. FinTechs zahlen darüber, oft deutlich. Die Bereitschaftszulage kommt hinzu und wird gern übersehen, wenn Angebote verglichen werden.
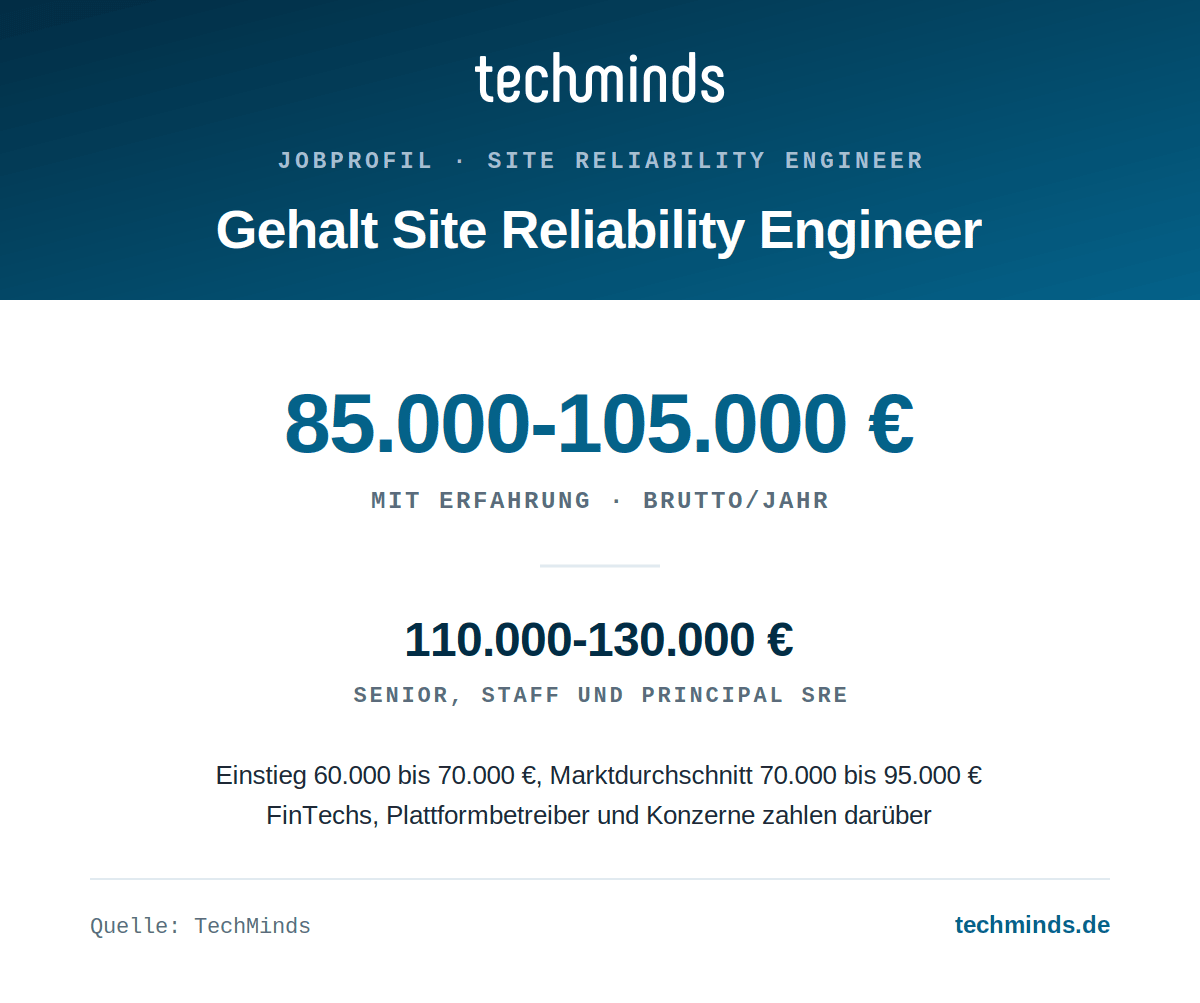
Einordnung: In der TechMinds Gehaltsstudie IT & Engineering steht diese Rolle auf der Ebene Senior Professional im Fachbereich Cloud & Infrastruktur. Dort lassen sich die Gehaltsspannen aller 162 Tech-Rollen vergleichen.
Wie wird man Site Reliability Engineer?
Kaum jemand startet direkt als SRE. Der übliche Weg führt über ein Informatikstudium oder die Ausbildung zum Fachinformatiker und danach ein paar Jahre Betrieb. Die meisten kommen aus der Systemadministration, einige aus der Backend-Entwicklung. Beides zusammen ist der Engpass. Entwickler unterschätzen, was ein Nachtdienst mit einem Team macht. Administratoren scheuen sich, eigene Software zu schreiben.
Zertifikate der Cloud-Anbieter belegen Grundlagen und mehr nicht. Im Gespräch überzeugt, wer von einem konkreten Ausfall erzählen kann und davon, was danach automatisiert wurde. Von dort führt der Weg zum Senior und Staff SRE, in Architektur- oder Führungsrollen wie Head of Platform Engineering oder in Richtung Cloud-Architektur.
Wie KI die Rolle des Site Reliability Engineers verändert
Am schnellsten verändert sich die Störungsbearbeitung. Überwachungssysteme bündeln Alarme inzwischen selbst und nennen eine wahrscheinliche Ursache, und den Verlauf einer Störung kann ein Assistent zusammenfassen, meist samt einem ersten Entwurf des Postmortems. Die Nachbesprechung im Team lässt sich damit allerdings nicht abkürzen. Gleichzeitig wächst das Aufgabenfeld, weil der Betrieb von KI-Anwendungen häufig beim SRE landet. Solche Systeme fallen anders aus als klassische Software, da sie selten abstürzen und stattdessen schlechter antworten, was oft zuerst im Kundenkontakt auffällt.
Der manuelle Anteil bleibt dabei erheblich. Der SRE Report 2026 beziffert den Anteil wiederkehrender Routinearbeit (Toil) auf rund ein Drittel der Arbeitszeit, und nur etwa die Hälfte der Befragten erwartet, dass er durch KI sinkt. Diagnose und Entscheidung bleiben deshalb in der Regel Aufgabe des Teams, auch wenn die Werkzeuge inzwischen brauchbare Hinweise liefern.
Der Zuschnitt der Rolle verschiebt sich damit vom Reagieren zum Gestalten. Ein Site Reliability Engineer entwirft die Automatisierung, bewertet die Vorschläge der Systeme und legt fest, an welchen Stellen Menschen eingreifen müssen. Für die Besetzung gewinnt damit Erfahrung mit Automatisierung und mit dem Betrieb datengetriebener Anwendungen an Gewicht.


Ihr Headhunter für Site Reliability Engineers
Sie suchen Site Reliability Engineers? Die Zielgruppe ist überschaubar und bewirbt sich selten. TechMinds kennt sie aus Mandaten bei SaaS-Anbietern und Plattformbetreibern und spricht sie direkt an. Jeder vierte vorgestellte Kandidat erhält bei unseren Kunden ein Vertragsangebot. Nehmen Sie Kontakt auf, das Erstgespräch ist unverbindlich und vertraulich. Wie TechMinds solche Positionen besetzt, zeigt der Headhunter für Platform Engineering.
Grafiken: Die Infografiken dürfen gerne verwendet und geteilt werden. Bitte nennen Sie als Quelle diesen Beitrag oder techminds.de